Gestion des incidents TIC DORA
Une alerte technique ne devient exploitable que si elle est reliée au service financier touché, à une chronologie fiable et aux personnes capables de décider. Sans chaîne d’escalade claire, quelques minutes perdues peuvent aggraver l’indisponibilité, la perte de données et le risque réglementaire.
Dans le cadre de son accompagnement à la conformité DORA, ACI Technology vous aide à structurer la gestion des incidents TIC : surveillance, qualification, confinement, rétablissement et production des preuves. L’entité financière conserve la classification, la notification et les échanges avec l’autorité compétente.
Un processus complet, avant et après l’alerte
Ce que DORA attend de la gestion des incidents TIC
Dans le secteur financier, le règlement européen DORA — Digital Operational Resilience Act — impose depuis le 17 janvier 2025 aux entités financières de l’Union européenne un cadre de gestion capable de prévenir et gérer les incidents liés aux technologies de l’information et de la communication. Le processus de gestion des incidents doit permettre de détecter, enregistrer, classer et traiter chaque événement puis, s’il devient majeur, de préparer sa notification dans les délais applicables.
Ce cadre de gestion attribue les rôles, organise les remontées internes et la communication, puis informe la direction des incidents majeurs. Il prévoit aussi l’analyse des causes et les mesures de prévention nécessaires pour rétablir des services opérationnels et sécurisés.
- Détecter : faire remonter les anomalies, les alertes et les signaux faibles suffisamment tôt.
- Qualifier : relier l’événement aux actifs, aux utilisateurs et aux fonctions touchées.
- Répondre : contenir l’impact, coordonner les intervenants et sécuriser le retour au service.
- Documenter et escalader : conserver les décisions et fournir les informations utiles à la classification et à la déclaration.
Ce processus de gestion alimente un registre des incidents partagé avec les fonctions autorisées. Il conserve le statut, le service concerné, les responsables, les mesures prises et les justificatifs disponibles. Le suivi permet ensuite d’identifier les événements récurrents et de renforcer la résilience opérationnelle numérique.
Donner un sens métier aux événements
Quels événements deviennent des incidents TIC au sens de DORA ?
Une alerte, une erreur applicative, une saturation ou une défaillance matérielle devient un incident lié aux TIC lorsqu’elle compromet les réseaux, les systèmes d’information, la disponibilité, l’authenticité, l’intégrité ou la confidentialité des données, ou les services fournis par l’entité financière.
L’origine peut être une cyberattaque, une panne, une erreur humaine, une mauvaise configuration ou la défaillance d’un prestataire tiers. Tous les incidents sont enregistrés, mais seuls ceux qui atteignent les critères réglementaires deviennent des incidents majeurs soumis à déclaration. La détection doit donc préserver dès l’origine les informations nécessaires à leur classification.
Construire une chronologie fiable
Détecter, consigner et préserver les preuves nécessaires
La détection combine supervision du parc, journaux des systèmes, outils de sécurité, remontées du support, notifications des fournisseurs et signalements des utilisateurs. Chaque alerte est rapprochée des actifs et des fonctions critiques ou importantes afin de déterminer son urgence et les responsables à prévenir.
Dès l’ouverture, un identifiant et une horodatation cohérente structurent le dossier. Celui-ci distingue les faits des hypothèses, consigne les systèmes touchés, les premiers impacts, les actions et les décisions. Les journaux utiles sont préservés selon les règles d’accès et de conservation de l’entité financière.
- Point de départ : date et heure de détection, déclarant, outil ou prestataire à l’origine du signalement.
- Périmètre : actifs, applications, utilisateurs, sites, données et services potentiellement touchés.
- État du service : indisponibilité, dégradation, contournement et effets visibles.
- Chronologie et preuves : alertes, décisions, tickets, journaux, captures et rapports techniques disponibles.
Une surveillance continue du parc informatique alimente cette collecte ; elle ne remplace pas les règles de qualification, d’escalade et de décision propres au client.
Limiter l’impact sans perdre la maîtrise
Contenir, corriger et coordonner la réponse
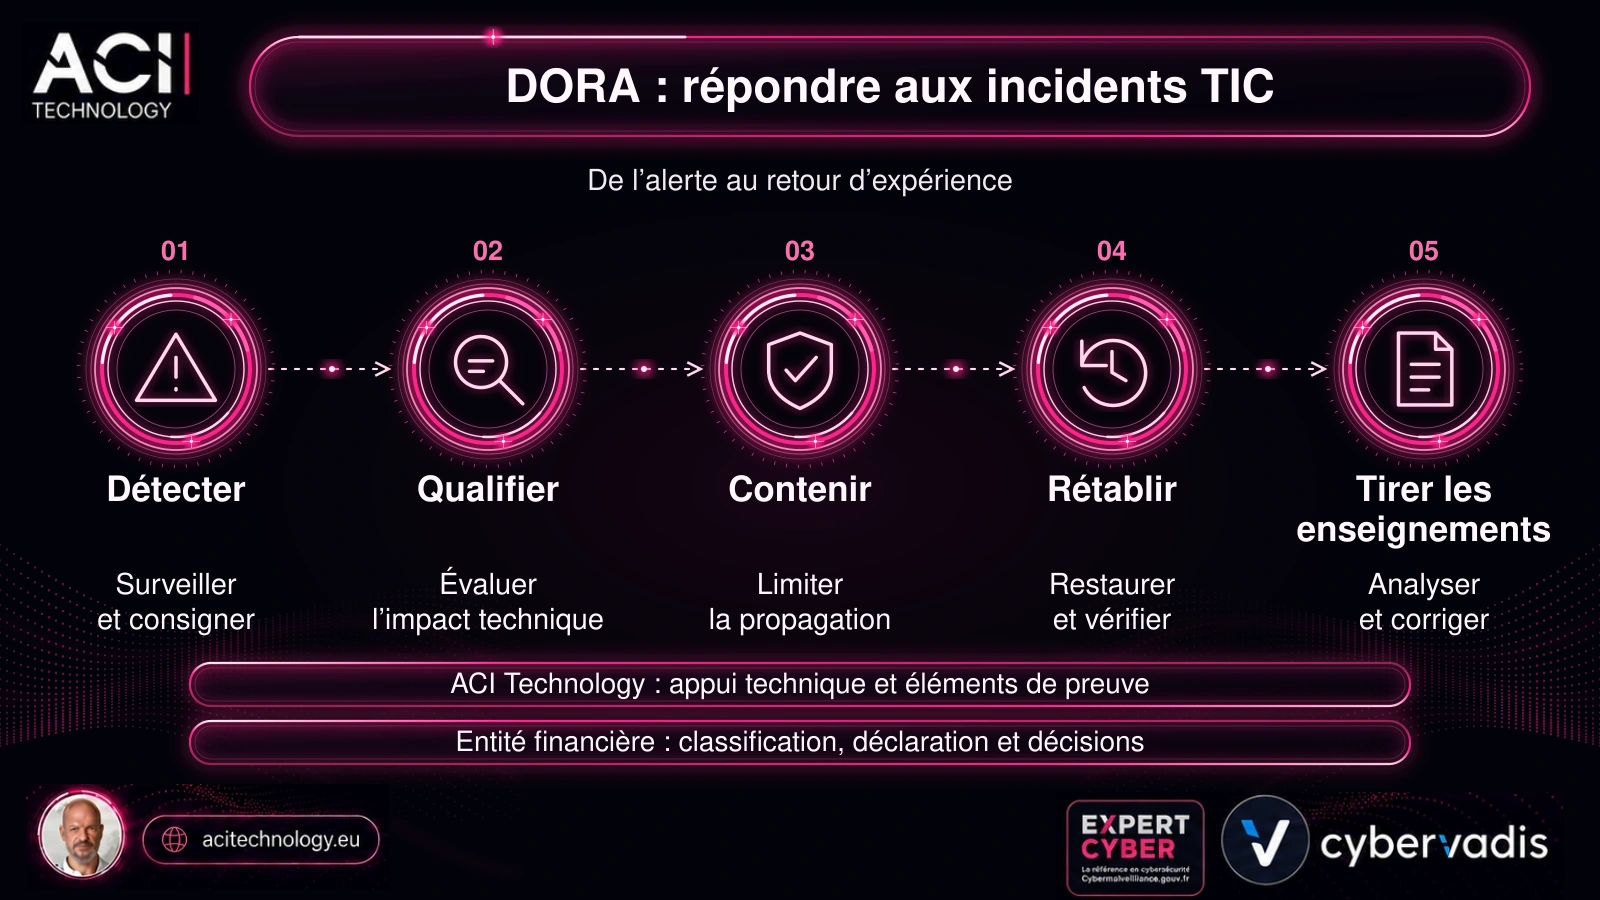
Les premières mesures empêchent l’extension de l’incident tout en protégeant les fonctions importantes. Isoler un poste, suspendre un compte, filtrer un flux ou basculer vers une solution de secours doit rester autorisé, proportionné et tracé : une correction précipitée peut détruire des preuves ou provoquer une nouvelle indisponibilité.
Une chaîne d’appel connue relie support, exploitation, sécurité, responsable métier, risques, conformité, direction et intervenants externes. Un pilote centralise la situation, répartit les actions et rythme les points de suivi. La communication interne et client reste fondée sur des faits confirmés.
- Triage : confirmer l’incident, estimer son urgence et identifier le service métier exposé.
- Confinement : réduire la propagation et préserver les fonctions qui peuvent continuer en sécurité.
- Investigation et correction : identifier l’origine, corriger la vulnérabilité ou remplacer le composant défaillant.
- Coordination : informer les responsables et solliciter les tiers utiles selon la chaîne d’escalade.
Le point de contact et d’escalade peut être assuré par ACI selon les horaires, priorités et niveaux de service définis au contrat.
Préparer la décision réglementaire
Classifier un incident TIC et préparer sa notification DORA
La priorité du support ne détermine pas à elle seule la classification réglementaire. Le règlement délégué (UE) 2024/1772 détaille sept critères permettant à l’entité financière d’identifier les incidents majeurs :
- Clients et transactions : nombre et importance des clients ou contreparties touchés, volume et montant des opérations affectées.
- Réputation : visibilité de l’incident, plaintes répétées ou risque d’affecter durablement la clientèle.
- Durée : heure de début, durée de l’incident et indisponibilité du service.
- Portée géographique : incidence dans un ou plusieurs États membres.
- Données : atteinte à leur disponibilité, authenticité, intégrité ou confidentialité.
- Criticité : fonction critique ou importante et service financier réglementé touchés.
- Impact économique : coûts et pertes directs ou indirects liés à l’incident.
Quels sont les délais de notification d’un incident majeur ?
Lorsqu’un incident est classé comme majeur, sa notification suit trois étapes. Le règlement d’exécution (UE) 2025/302 fixe les modèles harmonisés à utiliser.
| Étape | Délai et informations attendues |
|---|---|
| Notification initiale | Le plus tôt possible, au plus tard 4 heures après la classification et 24 heures après la prise de connaissance. Les informations peuvent encore être partielles. |
| Rapport intermédiaire | Dans les 72 heures suivant la notification initiale. Il complète la chronologie, les composants touchés, les mesures prises et l’état du rétablissement. |
| Rapport final | Dans un délai de 1 mois après le rapport intermédiaire ou sa dernière mise à jour. Il consolide notamment les causes, les mesures, le rétablissement et les coûts. |
Préparer la notification et répartir les responsabilités
En France, la notification est adressée à l’autorité compétente selon le statut de l’entité : notamment l’ACPR pour les banques et organismes d’assurance, ou l’AMF pour les acteurs relevant de sa supervision.
ACI fournit les éléments techniques, mais ne décide pas qu’un incident est majeur et ne soumet pas la notification d’incident majeur DORA, sauf mission contractuelle explicite. L’entité financière reste pleinement responsable de cette obligation.
Cette organisation doit être préparée avant la crise. L’entité financière identifie l’autorité nationale compétente, les personnes habilitées à notifier, les accès au portail, les modèles à utiliser et le canal de secours. Elle définit également une stratégie de communication et les validations internes. Ces exigences évitent que le délai réglementaire soit absorbé par la recherche d’un identifiant, d’un contact ou d’une version du rapport.
Reprendre sans réintroduire le risque
Restaurer le service et sécuriser le retour à la normale
Rétablir ne consiste pas seulement à redémarrer un serveur. Le service est restauré selon les priorités métier, après contrôle des données, des accès et de la cause de l’incident. La reprise est validée par le responsable métier et suivie d’une surveillance renforcée ; tout écart temporaire reçoit un responsable et une échéance.
- Prioriser : rétablir d’abord les fonctions critiques ou importantes et leurs dépendances indispensables.
- Restaurer : utiliser des sauvegardes contrôlées ou une infrastructure de secours.
- Vérifier : tester les données, les flux, les accès et le fonctionnement attendu avec les équipes métier.
- Surveiller : maintenir une vigilance renforcée et détecter toute récidive ou anomalie résiduelle.
La gestion d’incident doit être articulée avec le plan de reprise d’activité et le maintien en condition opérationnelle des systèmes essentiels.
Transformer l’incident en amélioration
Analyser les causes et mettre à jour les risques
L’analyse post-incident rapproche les faits techniques, les décisions et les effets métier. Elle recherche l’origine de l’événement et les facteurs aggravants : actif mal inventorié, alerte ignorée, droit excessif, procédure incomplète, sauvegarde inutilisable ou coordination tardive. Le rapport final distingue la correction immédiate du plan durable. Les incidents récurrents de même cause sont rapprochés et peuvent, sous certaines conditions, être classés ensemble par l’entité financière.
- Capitaliser : conserver la chronologie validée, les causes, les impacts et l’efficacité de la réponse.
- Corriger : mettre à jour configurations, procédures, contrats ou capacités de reprise.
- Réévaluer et contrôler : réviser le risque puis vérifier l’efficacité des mesures nouvelles.
Répéter avant la crise
Tester la procédure DORA de gestion d’incident
Une procédure jamais jouée peut cacher un contact obsolète, un rôle mal défini ou une information impossible à extraire. Un exercice sur table — indisponibilité, rançongiciel, corruption de données ou panne cloud — vérifie la chaîne d’alerte, la coordination, le retour au service et la préparation de la notification : heure de prise de connaissance, critères, informations disponibles et validation.
Ces tests de résilience évaluent également la protection des données, la stratégie de réponse et la capacité à notifier l’autorité dans les délais prévus. Chaque test produit un plan d’amélioration suivi.
- Scénario et participants : événement crédible joué par l’IT, les métiers, les risques, la conformité et les tiers utiles.
- Objectifs : détection, escalade, décision, communication, rétablissement et preuves.
- Résultats : écarts, actions correctives, responsables et date de vérification.
Étendre la chaîne d’escalade
Gérer un incident provenant d’un prestataire tiers TIC
Un incident chez des prestataires de services TIC — cloud, SaaS, télécom ou infogérance — peut atteindre une fonction critique ou importante. Le contrat et le processus d’escalade précisent le signalement, les informations attendues, leur fréquence de mise à jour et la coopération au rétablissement. L’entité financière rapproche ensuite ces éléments de ses propres impacts ; un niveau de service respecté par le fournisseur n’écarte pas une classification majeure si les critères DORA sont atteints.
Lorsque plusieurs tiers de services TIC participent à la même chaîne, les responsabilités et les contacts doivent rester lisibles de bout en bout.
- Alerte contractuelle : contacts, délais convenus, niveaux de gravité et informations minimales attendues.
- Accès à l’information : chronologie, périmètre, cause probable, actions et estimation du rétablissement.
- Coordination et suivi : points de situation, preuves, rapport de cause et plan correctif.
Une contribution technique clairement délimitée
Comment ACI Technology intervient dans votre gestion des incidents TIC
ACI Technology intervient sur les opérations et preuves du périmètre confié : détection, ticket d’incident, confinement autorisé, coordination technique, rétablissement et chronologie. Cette contribution s’intègre au processus de gestion et aux responsabilités définies par le client.
- Préparation : contacts, niveaux d’escalade, accès d’urgence et sources de journaux.
- Détection et traitement : alertes, qualification, diagnostic, confinement et remédiation autorisée.
- Rétablissement : restauration, contrôles techniques et surveillance adaptée.
- Traçabilité : tickets, horodatages, éléments disponibles et rapport technique selon le contrat.
ACI ne remplace ni la direction ni les fonctions risques et conformité. La validation du caractère majeur et la déclaration à l’autorité compétente restent sous la responsabilité de l’entité financière, y compris lorsqu’un mandat contractuel encadre l’assistance d’un prestataire.
Besoin de relier vos alertes techniques à une chaîne d’escalade, de décision et de preuve réellement exploitable ?
Questions fréquentes sur les incidents TIC DORA
Qu’est-ce qu’un incident lié aux TIC au sens de DORA ?
C’est un événement non planifié qui compromet les réseaux, les systèmes d’information, des données ou un service de l’entité financière. Il peut résulter d’une cyberattaque, mais aussi d’une panne, d’une erreur ou d’un prestataire.
Tous les incidents TIC doivent-ils être déclarés ?
Non. Tous doivent être enregistrés et gérés, mais la notification des incidents à l’ACPR, à l’AMF ou à l’autre autorité compétente vise ceux qui sont classés comme majeurs. Les cybermenaces importantes peuvent faire l’objet d’une notification volontaire.
Qui décide qu’un incident TIC est majeur ?
L’entité financière applique les sept critères DORA et conserve la décision. Les équipes techniques fournissent les faits nécessaires : service touché, chronologie, clients ou transactions affectés, données, durée, portée géographique et coûts.
Quels sont les délais de notification d’un incident majeur DORA ?
La notification initiale est due au plus tard 4 heures après la classification et 24 heures après la prise de connaissance. Le rapport intermédiaire suit sous 72 heures, puis le rapport final sous 1 mois. Le statut et les instructions de l’autorité compétente, notamment l’ACPR ou l’AMF, doivent être vérifiés.
ACI peut-il effectuer la déclaration d’incident DORA ?
ACI prépare les données et modèles techniques. Une transmission à l’ACPR, à l’AMF ou à une autre autorité n’est réalisée que si le contrat le prévoit et après validation du client. L’entité financière reste responsable de l’obligation de déclaration.
DORA impose-t-il une surveillance 24 h/24 et 7 j/7 ?
Le règlement européen DORA exige une détection adaptée au profil de risque et aux activités importantes, mais pas un SOC 24/7 universel. La couverture, l’astreinte et les délais d’escalade doivent être définis dans le cadre de gestion et les contrats.
Que faire si l’incident provient d’un prestataire TIC ?
Activez les contacts contractuels, collectez la chronologie et mesurez les conséquences sur vos services, clients et informations. L’origine externe ne retire pas la responsabilité de l’entité financière en matière de classification et de notification.
Quelles sanctions en cas de notification tardive ou incomplète ?
Une notification tardive, absente ou inexacte peut constituer une non-conformité et exposer l’entité à des mesures de contrôle ou à des sanctions prévues par le droit applicable. L’ACPR ou l’AMF apprécie la situation selon sa compétence ; ACI ne qualifie pas le risque de sanctions.